Seedance、Veo、Gemini Omniなど、さまざまな動画生成AIが登場し、以前と比べて誰でも簡単にAIで動画を作れるようになってきました。
SNSでも、動画生成AIを使って作られたハイクオリティな動画を見かける機会がかなり増えています。そうした動画を見て、「自分でもAI動画を作ってみたい」と思ったことがある方も多いのではないでしょうか。
しかし、実際に動画生成AIを使ってみると、次のようなことも少なくありません。
- 思った通りの映像にならない
- 指示した内容がうまく反映されない
- SNSで見るようなクオリティにならない
- 何度生成しても微妙に違う動画が出てくる
pitattoでも、AI動画制作を始めた当初は、狙った動画を作るまで何度も試行錯誤を繰り返していました。現在では100件以上の動画生成・検証を重ね、その中で「こうすると狙った動画を作りやすい」といういくつかの傾向が見えてきています。
もちろん、動画生成AIは急速に進化しているため、すべてのモデル・すべてのケースに当てはまるわけではありません。この記事では、pitattoが実際にAI動画を制作してきた中で感じた、思い通りの動画を生成するためのコツをご紹介します。
この記事の結論
- 出力を左右するのはプロンプトだけではない。モデル・品質設定・生成方法・参照画像の組み合わせで結果は変わる
- プロンプトは使用するモデルに合わせて書き換える。まず公式のプロンプトガイドを読むのが近道
- 何度書き直しても変わらないときは、プロンプトではなくモデルや生成品質の設定を疑う
- まず低コストな設定で構図と動きを確認し、方向性が決まってから高品質なモデルで仕上げる
- 商品や人物など「変えたくないもの」があるなら、Text-to-Videoではなく参照画像を使う
- 1回の生成で完成させようとしない。意図と違った点を一つずつ切り分けて修正する
AI動画生成は「プロンプト」だけで決まるわけではない
AI動画生成というと、「良いプロンプトを書けば、良い動画が作れる」と思われがちです。
もちろんプロンプトは非常に重要です。しかし、実際に動画生成を繰り返していると、動画のクオリティを左右するのはプロンプトだけではないと感じます。
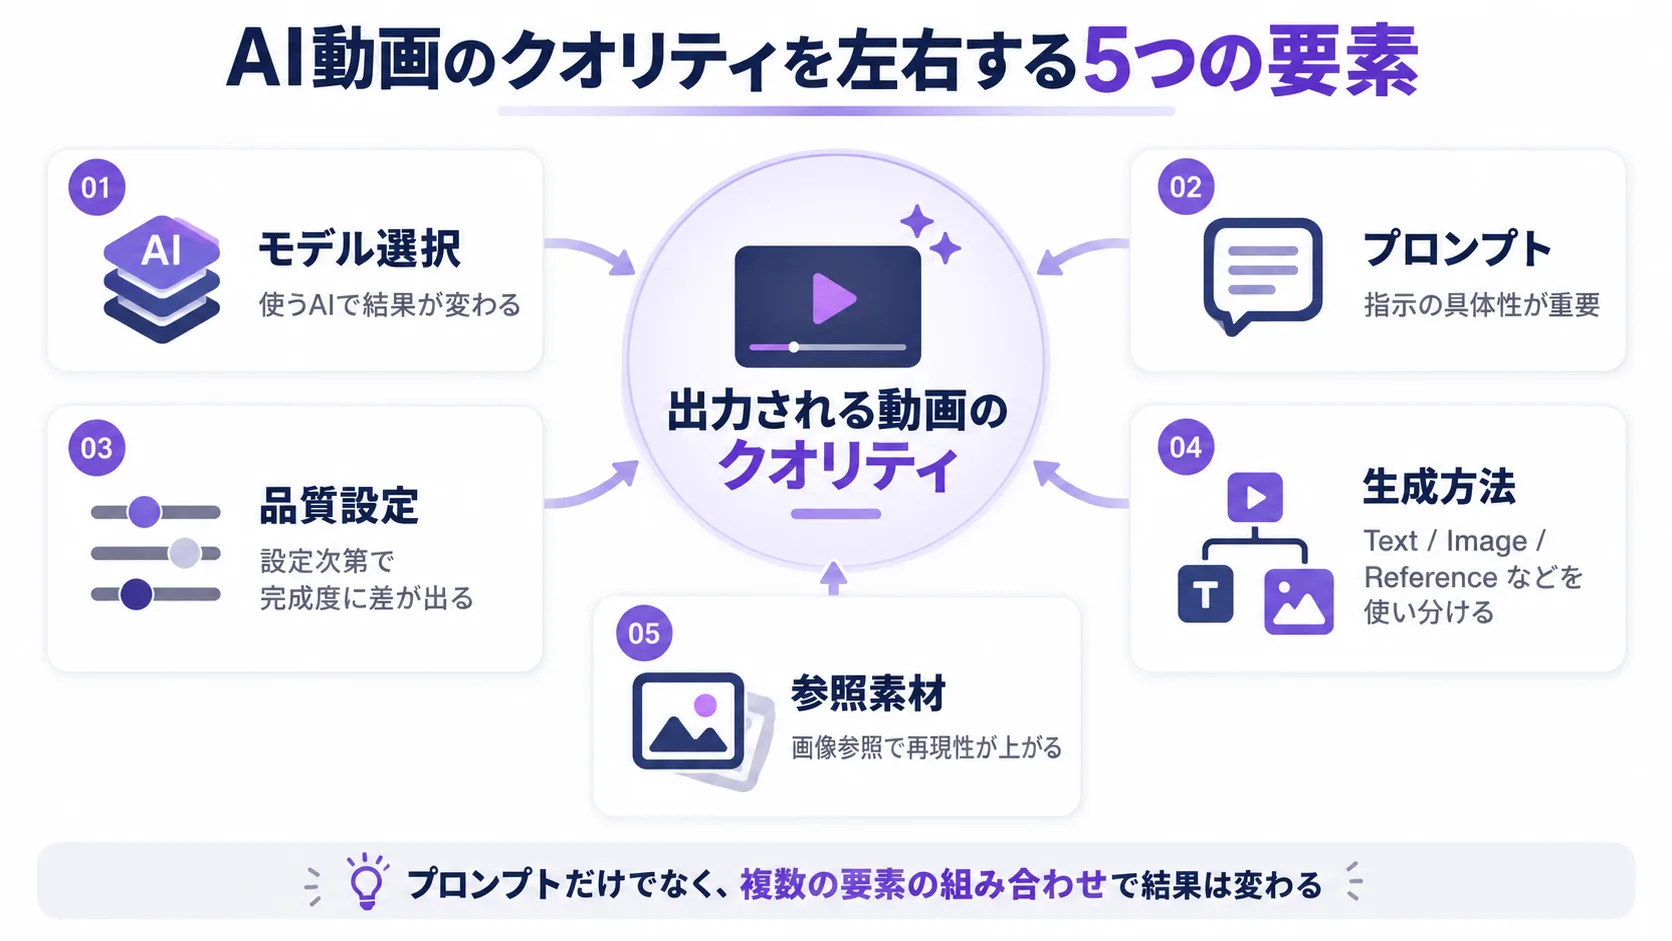
例えば、次のようなさまざまな要素によって出力結果は変わります。
- 使用する動画生成モデル
- プロンプトの書き方
- 使用するモデルや生成品質の設定
- Text-to-VideoやImage-to-Videoなどの生成方法
- AIに読み込ませる参照画像
- カメラワークや構図の指定
そのため、「プロンプトを何度書き直しても、なかなか思った動画にならない」という場合は、プロンプト以外の部分を見直した方が良いケースもあります。
ここからは、実際にpitattoで意識しているポイントをご紹介します。
コツ1|使用するモデルに合わせてプロンプトを変更する
まず意識したいのが、使用する動画生成AIに合わせてプロンプトを調整することです。
動画生成AIに入力する指示文のことを「プロンプト」と呼びます。基本的には、次のような内容を伝えて動画を生成します。
- 何を映すのか
- どのように動くのか
- どこで撮影しているのか
- どのようなカメラワークなのか
- どのような雰囲気なのか
ただし、同じプロンプトをすべての動画生成AIにそのまま入力すれば、同じような結果が出るわけではありません。モデルによって、次のような点に違いがあります。
- 得意な指示の仕方
- カメラワークの解釈
- 長文プロンプトへの対応
- 画像参照の方法
- 音声やセリフへの対応
pitattoでも、あるモデルでは非常に良い結果が出たプロンプトを、別のモデルにそのまま入力すると、期待した結果にならないことがあります。
そのため、まずは使用しているモデルの公式ドキュメントやプロンプトガイドを確認することをおすすめします。GoogleのVeoなど、公式にプロンプトの書き方や推奨される指示方法を公開しているモデルもあります。
まず公式の推奨方法を理解し、そこから自分が作りたい動画に合わせて調整していくと、狙った結果に近づきやすくなります。
実際に、同じ化粧品のCMとして生成した2本を比べてみます。左は「化粧品のCM」という方向性だけを伝え、指示が曖昧なまま生成したもの。右は使用したモデルの推奨に沿って、被写体・動き・カメラワーク・雰囲気を具体的に指定したものです。
左の動画も、映像単体としては成立しています。しかし、カメラワークもカット割りも商品の見え方も、こちらが決めたものではありません。指示しなかった部分は、すべてAIが埋めます。
つまり、狙った動画に近づけるには「良いプロンプト」を探すより、そのモデルが何を指示として受け取れるのかを知り、埋めてほしくない部分を先に埋めておくほうが近道です。
コツ2|生成品質や上位モデルの選択も意外と重要
次に、pitattoが動画生成を繰り返す中で特に感じているのが、生成時の品質設定や使用するモデルによって、動画そのものの出来も変わることがあるという点です。
これは公式にすべてのサービスで保証されている仕様というわけではなく、あくまでpitattoが100件以上の動画生成を行ってきた中で感じている傾向です。
一般的に「画質設定」というと、「720pより1080pの方が映像がきれいになる」といった、単純な解像度の違いをイメージするかもしれません。もちろん解像度そのものは、映像の細かさに影響します。
しかし、pitattoでさまざまな動画生成サービスを検証していると、サービスによっては高品質側の設定や上位モデルを選択した際に、単純な映像の精細さだけでなく、次のように感じるケースが多くありました。
- プロンプトの内容をより正確に反映している
- 被写体の動きが自然になる
- カメラワークが指示に近づく
- 人物や商品の破綻が少なくなる
- 全体的な映像の完成度が高くなる
同じプロンプトを入力していても、通常モデルと上位モデルでは、単純な画質だけでなく出力される動画の内容そのものに差が出ることもあります。
そのため、何度プロンプトを調整しても思い通りにならない場合は、一度モデルや生成品質の設定を変更してみるのも一つの方法です。
サービスによっては、数十秒の動画を生成するだけでも数千円程度の生成コストがかかる場合があります。最初から最高品質の設定で何度も生成してしまうと、かなりコストが膨らんでしまいます。
そのためpitattoでは、まず低コストな設定で構図や動きを確認し、ある程度方向性が決まってから高品質なモデルで仕上げるという進め方をすることもあります。
AI動画生成では、クオリティだけでなく「どのタイミングでコストをかけるか」も重要です。
コツ3|Text-to-Videoだけで作ろうとしない
動画生成AIには、文章だけから動画を作る「Text-to-Video」以外にも、さまざまな生成方法があります。代表的なものとしては、次のような方法があります。
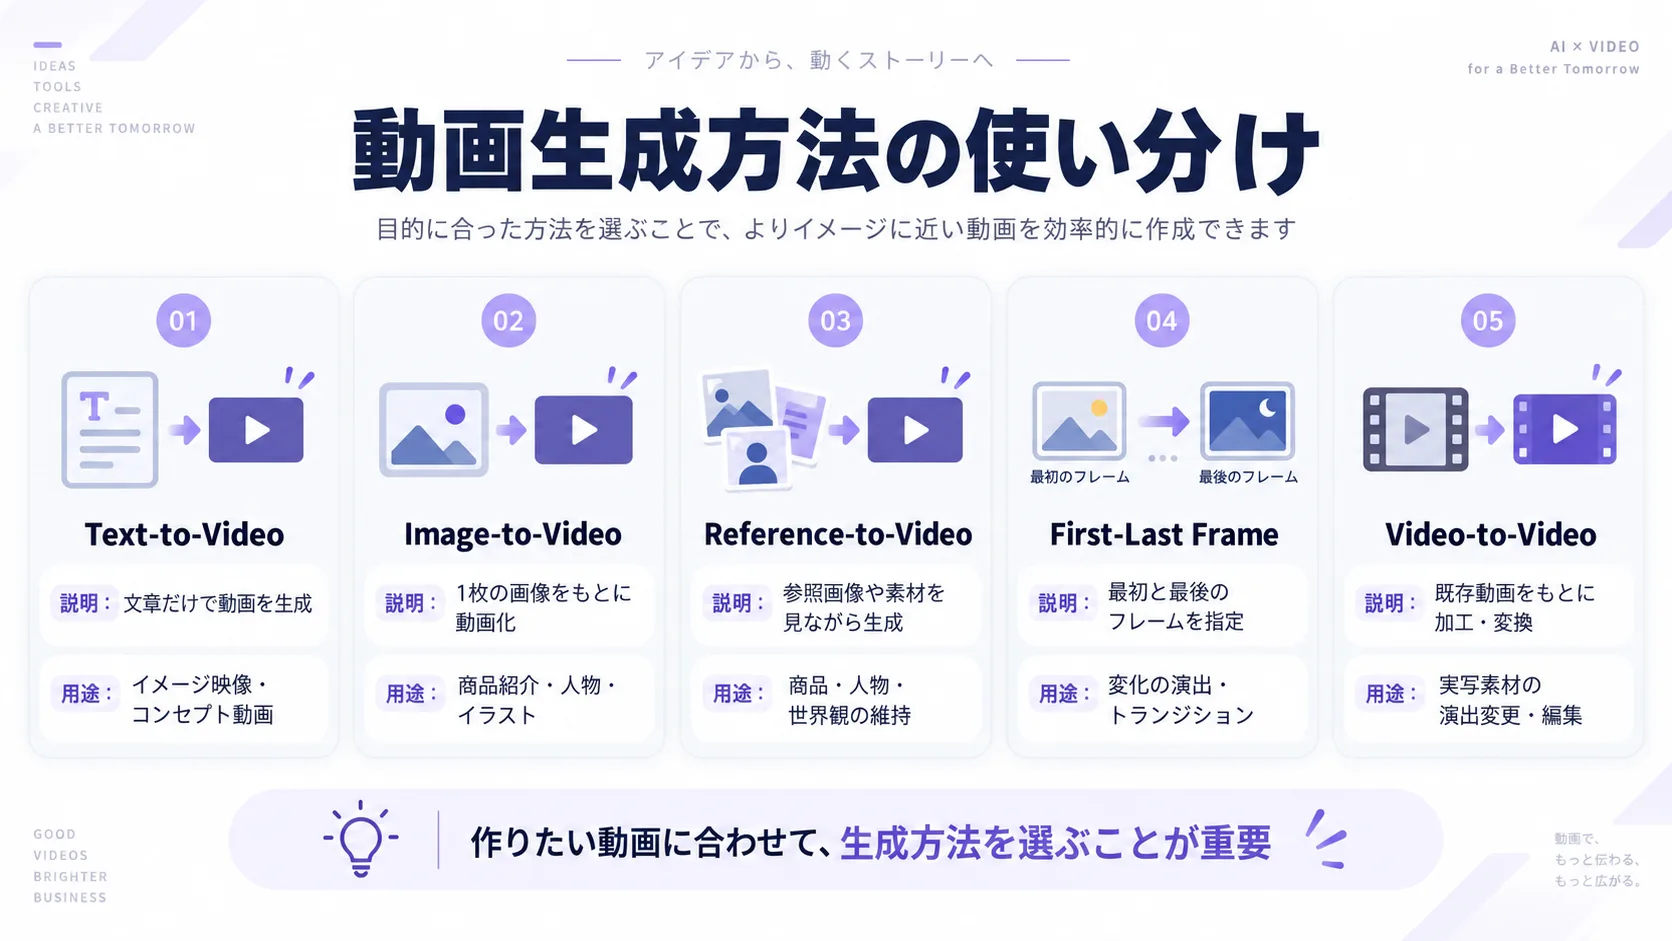
| 生成方法 | 特徴 | 向いている用途 |
|---|---|---|
| Text-to-Video | テキストだけから動画を生成 | イメージ映像、コンセプト動画 |
| Image-to-Video | 1枚の画像をもとに動画を生成 | 商品紹介、人物、イラスト |
| Reference-to-Video | 画像や動画などを参照して生成 | 商品・人物・世界観を維持した動画 |
| First-Last Frame | 開始フレームと終了フレームを指定 | 商品の変化、トランジション |
| Video-to-Video | 既存動画をもとに生成・編集 | 実写動画の演出変更、加工 |
思い通りの動画を作るためには、どの生成方法を選ぶかも非常に重要です。
例えば、実在する商品の紹介動画を作るとします。Text-to-Videoで、「この商品をテーブルの上に置いて、おしゃれなCM動画を作って」と指示したとしても、AIはその商品の正確な形状を知りません。
そのため、次のようなことが起こる可能性があります。
- パッケージが変わる
- ロゴが変形する
- 商品の色が変わる
- 全く違う商品が生成される
このようなケースでは、商品画像をAIに読み込ませたうえでImage-to-VideoやReference-to-Videoを利用した方が、狙った動画を作りやすくなります。
コツ4|商品や人物など「変えたくないもの」は参照画像を使う
AI動画生成では、AIに自由に考えてもらいたい部分と、絶対に変えてほしくない部分を分けることも重要です。
例えば商品広告の場合、「背景や演出はAIに考えてほしいけれど、商品自体のデザインは変えてほしくない」というケースが多いと思います。その場合は、商品の画像を参照させながら動画を生成する方が適しています。
AIに任せる部分
プロンプトで方向性だけ伝え、表現はAIに考えてもらう
- 背景・ロケーション
- 光の当たり方・時間帯
- カメラワーク・構図
- 全体の雰囲気・世界観
固定したい部分
参照画像として読み込ませ、AIに作らせない
- 商品の形状・パッケージ
- ロゴ・商品名の表記
- ブランドカラー
- 出演する人物の顔
例えば化粧品の広告で、「高級ホテルの洗面台に商品が置かれていて、カメラがゆっくり商品に近づいていく」という映像を作りたい場合。
Text-to-Videoだけで商品まで生成させるのではなく、実際の商品画像 + 背景やカメラワークのプロンプトという形で生成した方が、商品イメージを維持しながら演出を加えやすくなります。
一方、次のようにAIの想像力を最大限に活用したいケースでは、Text-to-Videoとの相性が良い場合もあります。
- 会社紹介動画のイメージカット
- 採用動画のコンセプト映像
- 抽象的なブランドムービー
- 架空の世界観を表現した動画
「とりあえずText-to-Videoを使う」のではなく、作りたい動画に合わせて生成方法を選ぶことが大切です。
コツ5|1回の生成で完成させようとしない
最後に、AI動画生成で非常に重要なのが、1回の生成で完璧な動画を作ろうとしないことです。
SNSなどでは完成したAI動画だけを見ることが多いため、「すごいプロンプトを入れれば、1回でこの動画が生成できるのでは?」と思ってしまうかもしれません。
しかし、実際のAI動画制作では、次の工程を繰り返すことが珍しくありません。
- 動画を生成する
- 出力結果を確認する
- 問題点を見つける
- プロンプトや設定を修正する
- 再度生成する
例えば、「人物の動きは良いけれどカメラワークが違う」のであれば、次はカメラの指示だけを具体的に変更します。反対に、「カメラは良いけれど商品の見え方が崩れている」のであれば、参照画像や生成方法を見直します。
すべてを一度に修正しようとするのではなく、どこが意図と違ったのかを一つずつ切り分けていくと、狙った映像に近づけやすくなります。
AI動画生成は「プロンプト」だけでなく、生成方法の選び方が重要
AI動画生成で思った通りの映像を作るためには、単純にプロンプトを工夫するだけではなく、次の部分も重要です。
- 使用するモデル
- モデルに合ったプロンプト
- 生成品質やモデルの選択
- Text-to-VideoやImage-to-Videoなどの生成方法
- 参照画像
- 試行錯誤の進め方
特に、「何をAIに自由に生成してもらい、何を固定するのか」を考えるだけでも、生成方法の選び方は大きく変わります。
AI動画生成はまだ発展途上の技術であり、モデルによって得意・不得意も大きく異なります。だからこそ、一つの方法にこだわるのではなく、作りたい動画に合わせてモデル・入力方法・設定を使い分けていくことが、クオリティを高める近道だと考えています。
AI動画制作ならpitattoにご相談ください
pitattoでは、これまで100件以上のAI動画生成・検証を重ねながら、動画の目的に合わせて生成モデルや生成方法を使い分けて制作を行っています。
- 「AI動画を使ってみたいけれど、どんな動画を作ればいいか分からない」
- 「自分で生成してみたけれど、なかなか思った通りにならない」
- 「商品やサービスの広告動画をAIで作りたい」
といったご相談も可能です。ご相談のみのお問い合わせでも問題ありません。
AIを活用した動画制作を検討されている方は、ぜひお気軽にpitattoまでお問い合わせください。